


Revelaciones impactantes sobre prácticas de entrenamiento de IA y sus implicaciones en la industria de medios
Una nueva filtración en la demanda por derechos de autor que The New York Times inició hace tres años contra OpenAI y Microsoft expone cómo altos ejecutivos calificaron el scraping de datos para inteligencia artificial como un «robo masivo de trabajo». Además, advierten que estos modelos de IA representan una amenaza existencial para las publicaciones y periodistas cuyas obras alimentan estas tecnologías.
Uso cuestionable de contenidos protegidos y bypass a muros de pago
Los documentos destapados revelan que las empresas implicadas habrían obtenido contenido protegido esquivando muros de pago sin detection y eliminando intencionalmente avisos de copyright en los datos usados para entrenar a la IA. Según una presentación interna de Microsoft, su motor Copilot redujo hasta en un 93% el tráfico hacia el sitio del New York Times, generando un «loop de desastre» que pone en riesgo la sostenibilidad de los creadores de contenido.
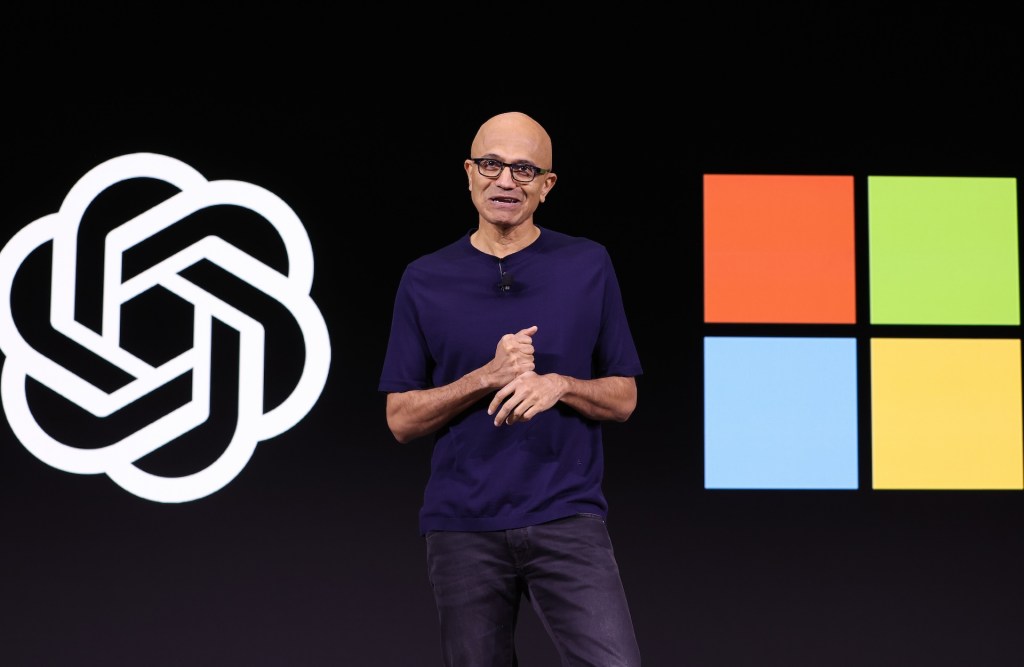
El director ejecutivo de Microsoft, Satya Nadella, afirmó en testimonios que cualquier contenido detrás de muros de pago debería ser licenciado para su uso en entrenamiento, y que de haber sabido del scraping desautorizado habría ordenado la reentrenación de modelos.
Implicaciones legales y económicas del entrenamiento con datos protegidos
La controversia gira en torno al concepto legal de «uso justo» (fair use) en el entrenamiento de IA con material protegido. Sin embargo, declaraciones del propio OpenAI reconocen que productos como chatbots sustituyen el acceso directo a noticias, afectando el mercado original. De hecho, un ejecutivo de OpenAI describió esta sustitución como una amenaza «existencial» para la industria editorial.
Los volúmenes de contenido copiado son sorprendentes: solo en sus conjuntos de datos intermedios, OpenAI tenía más de 91,000 copias de trabajos del NYT, Daily News y Center for Investigative Reporting, y un dataset derivado de Common Crawl incluía más de 2 millones de documentos solo de nytimes.com.
Cooperación entre Microsoft y OpenAI en los datos para entrenamiento
Los papeles legales también indican que OpenAI entregó a Microsoft el conjunto completo de datos de entrenamiento de GPT-3, que este último empleó para implementar los modelos en sus productos. A su vez, Microsoft facilitó datos a OpenAI a través de proyectos internos llamados Project Taxi y Project Mango, que al parecer incluyen copias únicas de casi 161,000 obras periodísticas.
Para optimizar el scraping, empleados de OpenAI desarrollaron métodos para evadir muros de pago sin ser detectados, e incluso diseñaron datasets específicos, como WebText, con un marcado sesgo hacia contenido de noticias copiadas masivamente.
Reflexión final y perspectivas
Estas revelaciones plantean serios interrogantes sobre el futuro del modelado de IA y su impacto en la industria editorial. Más información sobre la regulación legal y los desafíos éticos asociados puede encontrarse en el artículo original de TechCrunch.
En la actualidad, y a medida que tecnologías como OpenAI Astra y GPT-6 avanzan en inteligencia artificial general, el debate sobre el uso justo y la compensación justa a creadores de contenido se vuelve una cuestión crucial para el desarrollo responsable de IA (más detalles sobre OpenAI Astra y GPT-6).

Deja una respuesta